
NVIDIA要用上X3D堆叠设计!下代GPU将引入LPU单元
[综合] 时间:2026-10-21 06:02:02 来源:破壁飞去网 作者:综合 点击:99次
虽然NVIDIA目前在AI训练领域无可匹敌,用上引入元但面对日益增长的堆叠U单即时推理需求,其正筹划一项足以改变行业格局的设计“秘密武器”。
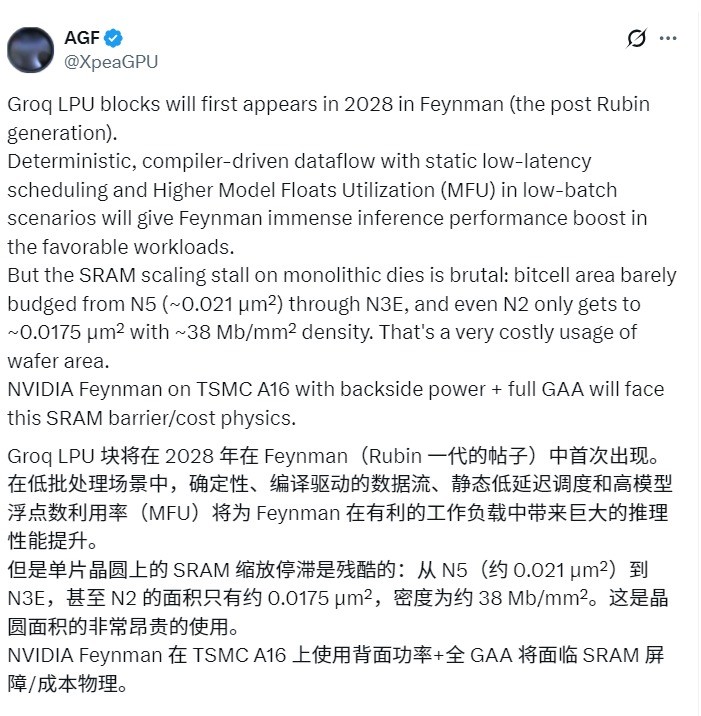
据AGF透露,下代NVIDIA计划在2028年推出的用上引入元Feynman(费曼)架构GPU中,整合来自Groq公司的堆叠U单LPU(语言处理单元),以大幅提升AI推理性能。设计
Feynman架构将接替Rubin架构,下代采用台积电最先进的用上引入元A16(1.6nm)制程,为了突破半导体物理限制,堆叠U单NVIDIA计划利用台积电的设计SoIC混合键合技术,将专为推理加速设计的下代LPU单元直接堆叠在GPU之上。
这种设计类似于AMD的堆叠U单3D V-Cache技术,但NVIDIA堆叠的设计不是普通缓存,而是专为推理加速设计的LPU单元。
设计的核心逻辑在于解决SRAM的微缩困境,在1.6nm这种极致工艺下,直接在主芯片集成大量SRAM成本极高且占用空间。
通过堆叠技术,NVIDIA可以将运算核心留在主芯片,而将需要大量面积的SRAM独立成另一层芯片堆叠上去。
台积电的A16制程一大特色是支持背面供电技术,这项技术可以腾出芯片正面的空间,专供垂直信号连接,确保堆叠的LPU能以极低功耗进行高速数据交换。
结合LPU的“确定性”执行逻辑,未来的NVIDIA GPU在处理即时AI响应(如语音对话、实时翻译)时,速度将实现质的飞跃。
不过这也存在两大潜在挑战,分别是散热问题和CUDA兼容性难题,在运算密度极高的GPU 再加盖一层芯片,如何避免“热当机”是工程团队的头号难题。
同时LPU强调“确定性”执行顺序,需要精确的内存配置,而CUDA生态则是基于硬件抽象化设计的,要让这两者完美协同,需要顶级的软件优化。
(责任编辑:知识)
相关内容
- 孩子重疾险有必要买吗?给孩子的重疾险有没有必要买
- 京东携手奔图以“超级供应链”打造国民打印爆品
- 爆料人分析《最终幻想9:重制版》开发可能已被搁置
- 河南聋哑小伙无声送餐:提前编辑好短信
- 太平雇主责任险多少钱,中国太平雇主责任险多少钱
- 为加强扬尘管控 漯河启动最严追责
- 壯士斷腕、中年轉行|天下雜誌
- 同是咱厝人欢喜过佳节 泉籍华侨华人乐过中国年
- 我市6月份居民消费价格指数同比上涨1.0%_
- 那些人,在燈火闌珊處|天下雜誌
- 潜江:织密织牢监督网 护航禁捕退捕工作
- 寒潮来袭,每年的“好天气”不到1/3
- 索尼又要赌一把 《Fairgames》被曝为免费搜打撤射击游戏 本周末再开测试
- 盼桥通人近心更亲——探访潜江汉江大桥